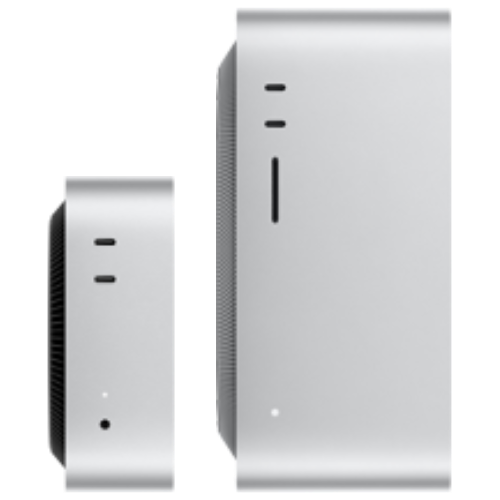
Mac mini 最適合 AI Agent
- Apple Silicon M6 晶片
- 12核心 CPU 搭配 12核心 GPU 處理器
- 24GB 統一記憶體
- 512GB SSD 儲存裝置
- 3埠 Thunderbolt 4、Wi-Fi 7、藍牙6、2.5G網路
- MAQ 售後遠端連線服務
- 預訂9月22日後出貨
Stable Diffusion 是一個將文字轉換為圖像的 AI 模型。它可以根據任何文字描述創建逼真的圖像。其進階版本 Stable Diffusion XL 擁有更大的網絡,能產生更高品質的圖像。預先安裝 ComfyUI Stable Diffusion 等 AI 開發環境,讓您收到電腦後,只需插上電源即可立即投入創作或研究。遇到任何系統問題,我們的專業團隊提供遠端協助,快速為您解決。
訂製 Stable Diffusion AI 工作站 訂製 SD PC
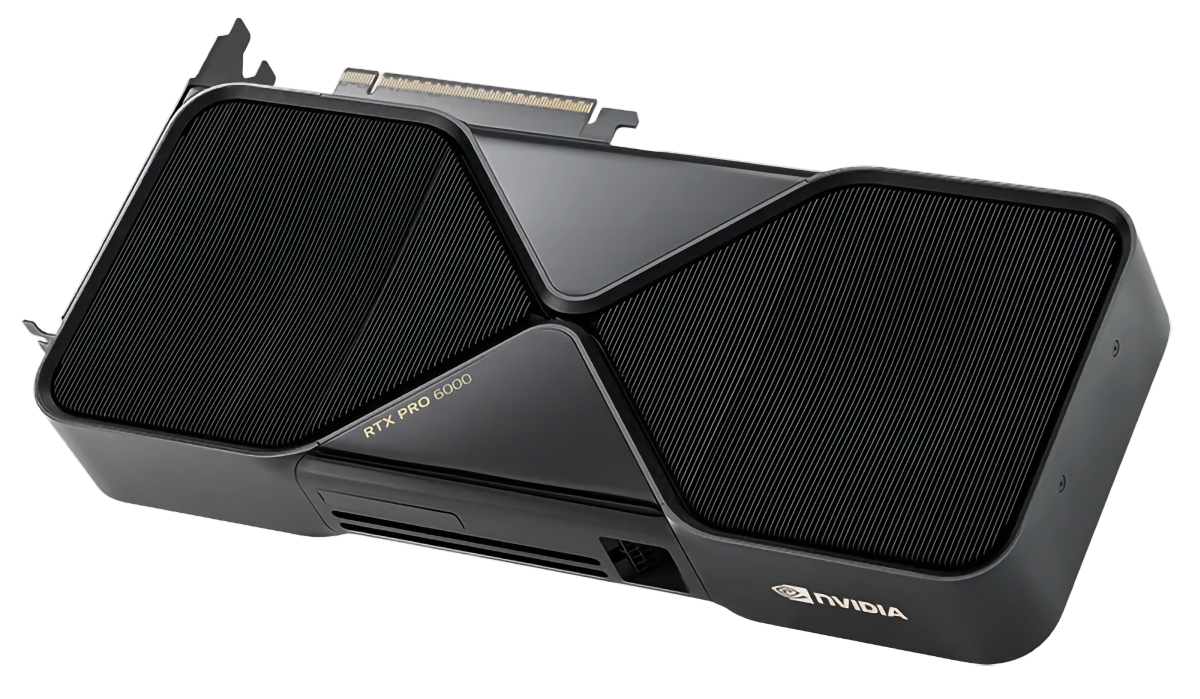
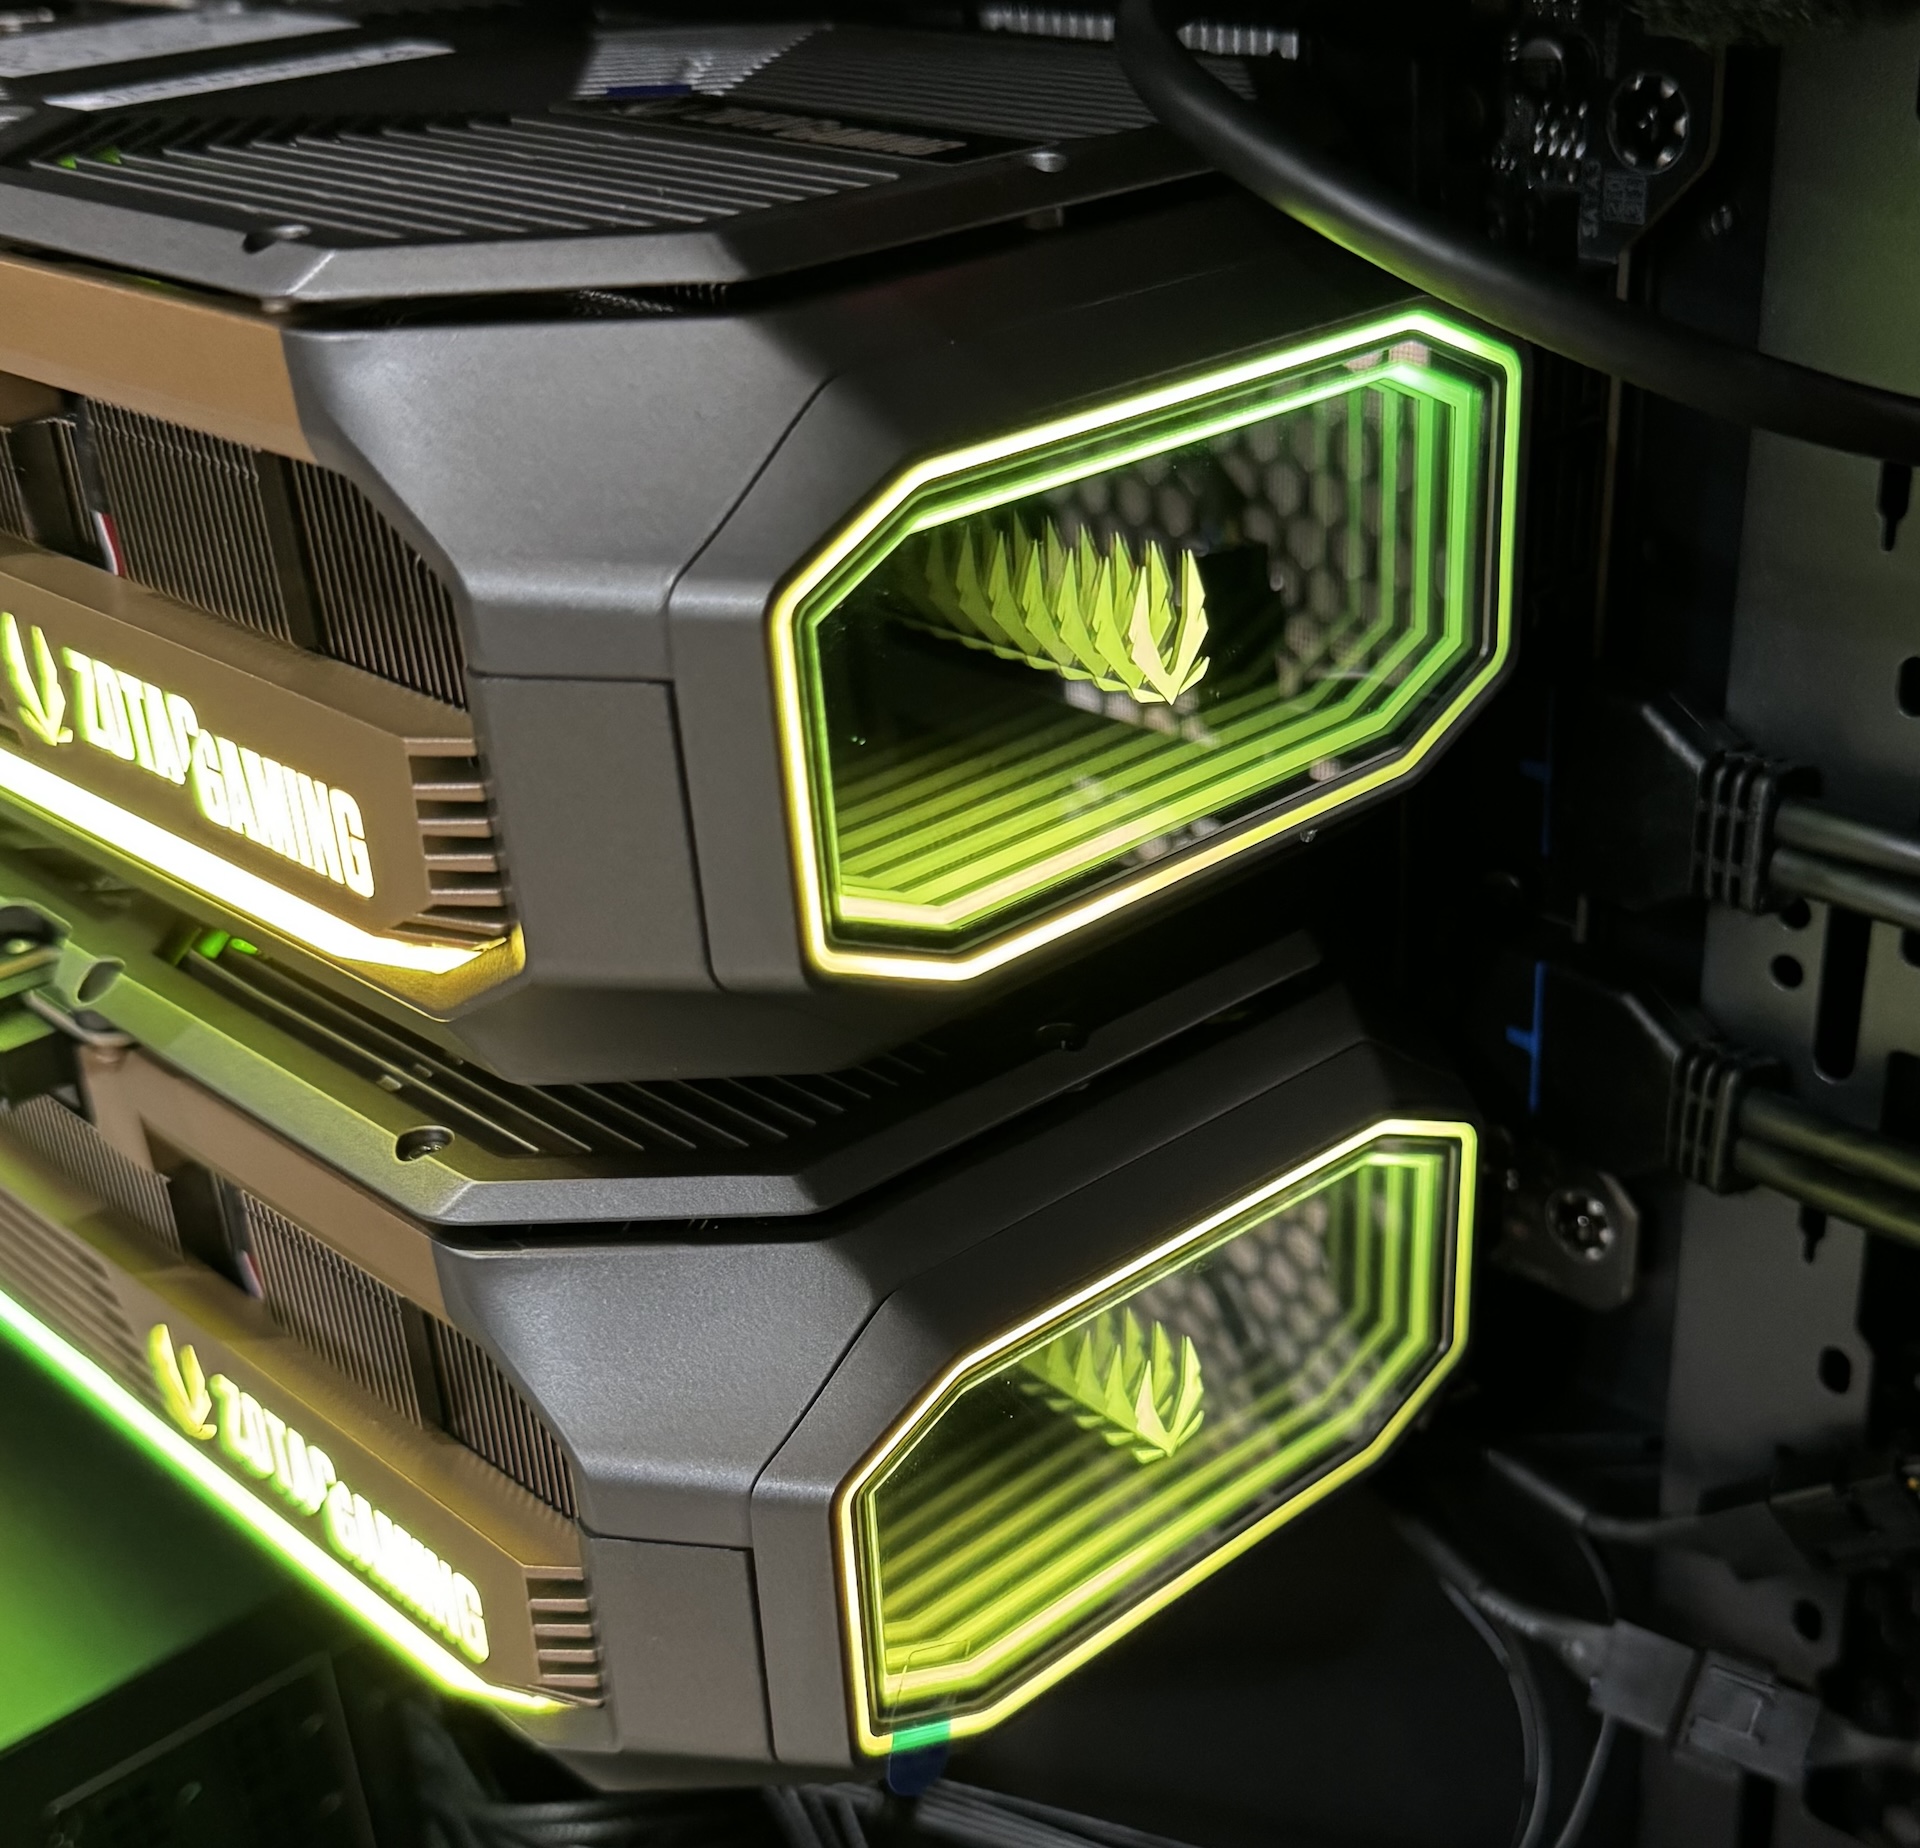

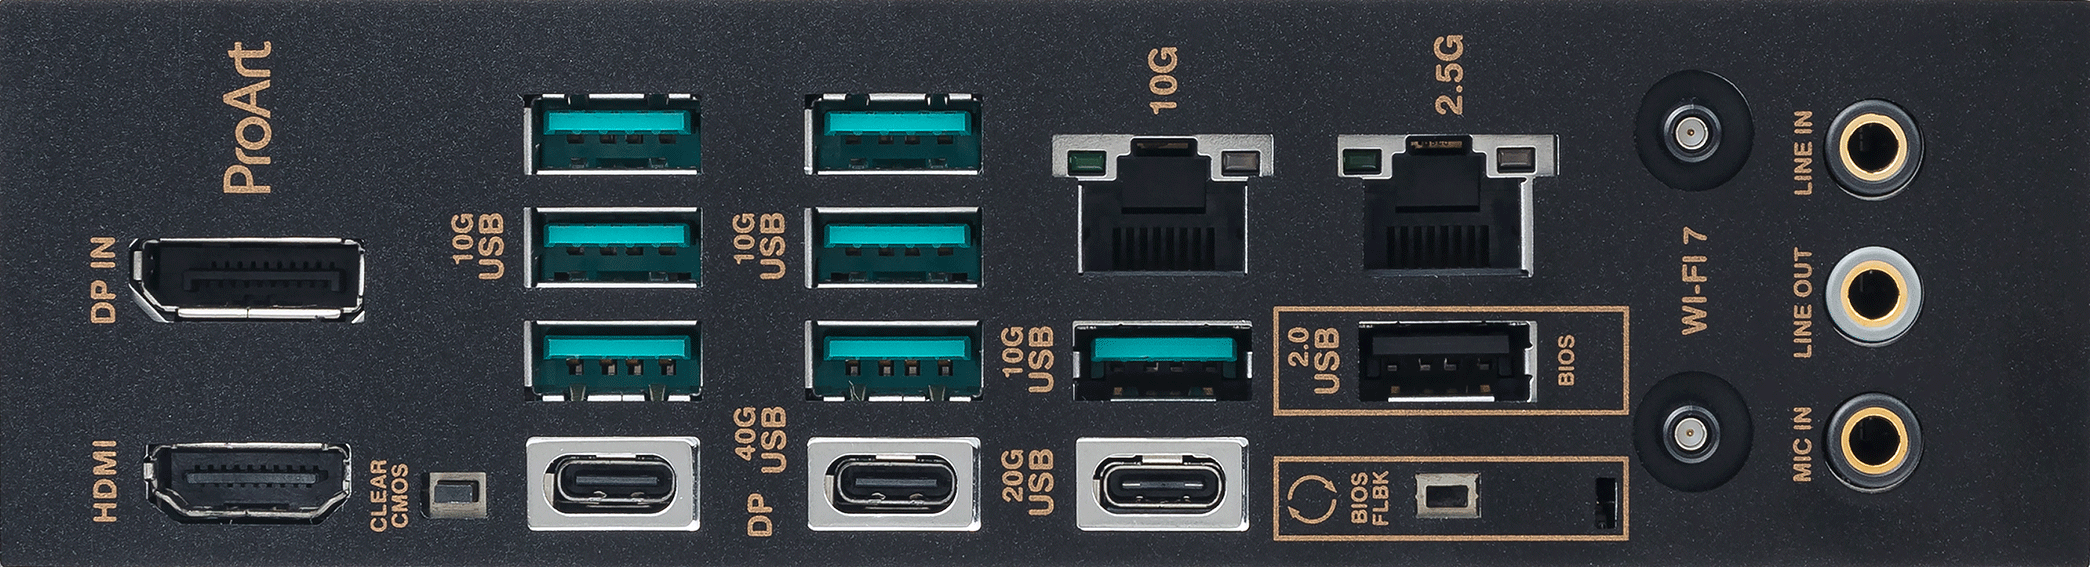
顯示卡路線以單張卡的顯示記憶體為上限,Apple Silicon 則由 CPU 與 GPU 共用同一池統一記憶體,整池都可用於推論。同樣要在單機載入 700 億參數級以上的模型,Mac Studio 不需要多卡並聯,也不需要張量並行。
代價是生態:訓練與大量影像生成仍以 NVIDIA CUDA 平台較為成熟。若工作以本地推論、私有檢索與常駐代理為主,Mac 線的低噪音與能源效率是實際優勢。
本頁的 Mac 機種出廠預載 MLX、Ollama 與 llama.cpp。完整機型與記憶體級距對照見 Mac 工作站。
可流暢運行 SDXL、Flux、SD 1.5/2.1、Stable Cascade 等主流生成式模型,搭配 ComfyUI、Automatic1111、Forge 等 webui 工作流。
依機型不同:至尊(RTX PRO 4500 32GB)約 1 秒、1 秒生成(RTX PRO 4000)約 1 秒、3 秒生成(RTX 5070 Ti)約 3 秒、5 秒生成(入門款)約 5 秒。以 SDXL 1024×1024、20 步為基準。
是。Stable-Diffusion 系列機型出廠時已安裝 ComfyUI 與常用 SDXL/Flux 權重,開機即用。
建議顯存 24GB 以上機型可同時 LoRA 微調與推論。32GB 以上機型(PRO 4500)可載入較大的 base model 進行訓練。
MAQ 提供遠端技術支援與簽約戶備機服務(維修期間借出接近規格備機),協助排除系統問題,讓您工作不中斷。
LLM 工作站靠大顯存 GPU 在本地推論大型語言模型;AI Agent 代理 PC 則以編排為主——多數情境呼叫雲端或本地的 LLM API,搭配 n8n、LangGraph、CrewAI 等代理框架串接工具、向量資料庫與瀏覽器自動化,因此 32GB 記憶體與多核 CPU 比高階獨顯更重要,入門價 3 萬元起。
若 LLM 推論交給雲端 API(OpenAI、Anthropic 等)或輕量本地模型,內建顯示即足夠,這也是 AI Agent 代理 PC 能壓低價格的原因。需要本地跑較大模型或加速 embedding 時,可加購獨立 GPU。
出廠預載 n8n、LangGraph、CrewAI、Ollama 與 Open WebUI,可直接接 Anthropic / OpenAI API 或本地 LLM,開機即可開始建置代理工作流。
定位不同。代理 PC 以「編排」為主,多數推論交給雲端或本地 API,因此 32GB 記憶體與多核 CPU 比高階獨顯重要,入門價 3 萬元起。NVIDIA DGX Spark 則以「在本機跑模型」為主:搭載 GB10 Grace Blackwell 超級晶片與 128GB 統一記憶體,單機即可載入大型模型進行本地推論與開發,19 萬元起。若代理流程的推理節點需要留在地端、或需在本機做模型開發與測試,選 DGX Spark;若主要是串接工具與工作流自動化,代理 PC 已足夠。
GB10 Grace Blackwell 超級晶片,包含 20 核心 ARM Cortex-X925 與 A725 CPU 及 NVIDIA Blackwell 架構 GPU;128GB 統一記憶體、4TB NVMe SSD;網路為 200GbE 加 10GbE、Wi-Fi 7 與 USB4 40G。統一記憶體架構讓 CPU 與 GPU 共用同一塊記憶體,是它能以迷你機身處理大型模型的原因。現貨供應。
兩者採用相同的 NVIDIA GB10 Grace Blackwell 超級晶片、20 核心 ARM Cortex-X925 與 A725 CPU、Blackwell 架構 GPU 與 128GB 統一記憶體,本地 LLM 開發與推論的核心能力相同。主要差異有三:其一為品牌,GX10 由 ASUS 推出、DGX Spark 為 NVIDIA 自有;其二為儲存容量,GX10 配置 1TB NVMe SSD、DGX Spark 為 4TB;其三為價格,GX10 為 17 萬元起、DGX Spark 為 19 萬元起。若以較低門檻取得 GB10 平台、且 1TB 儲存已足夠,可選 GX10;若需要更大的本機儲存空間,則選 DGX Spark。