LLM学習 マルチGPU
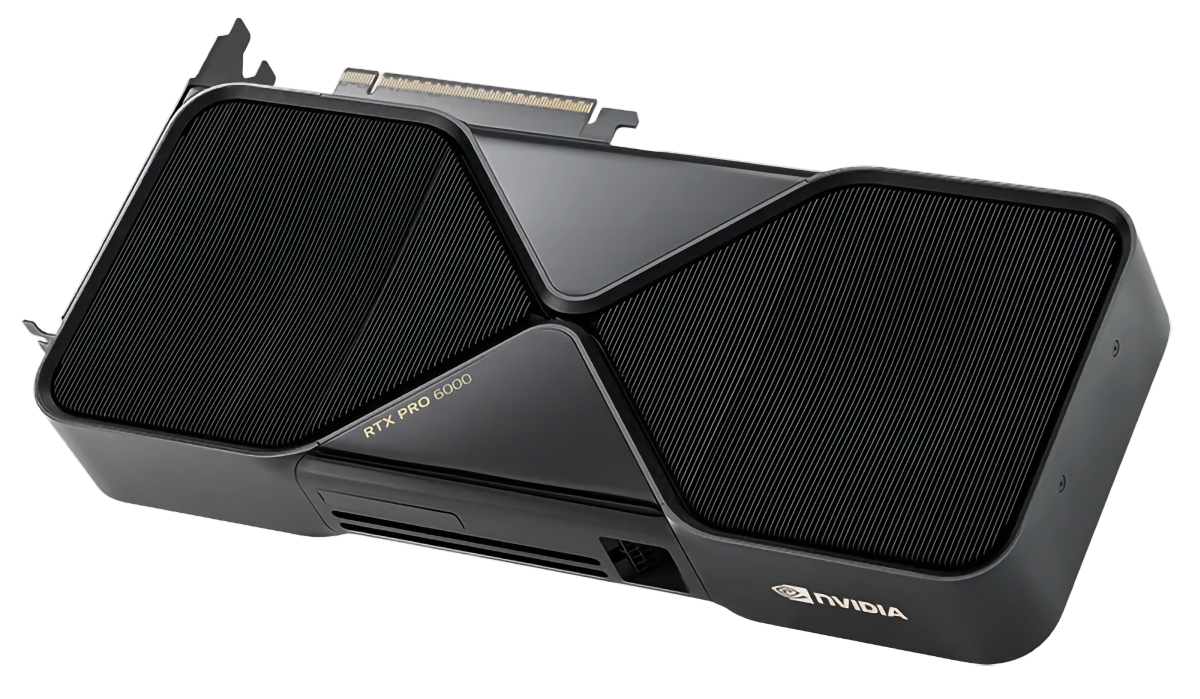
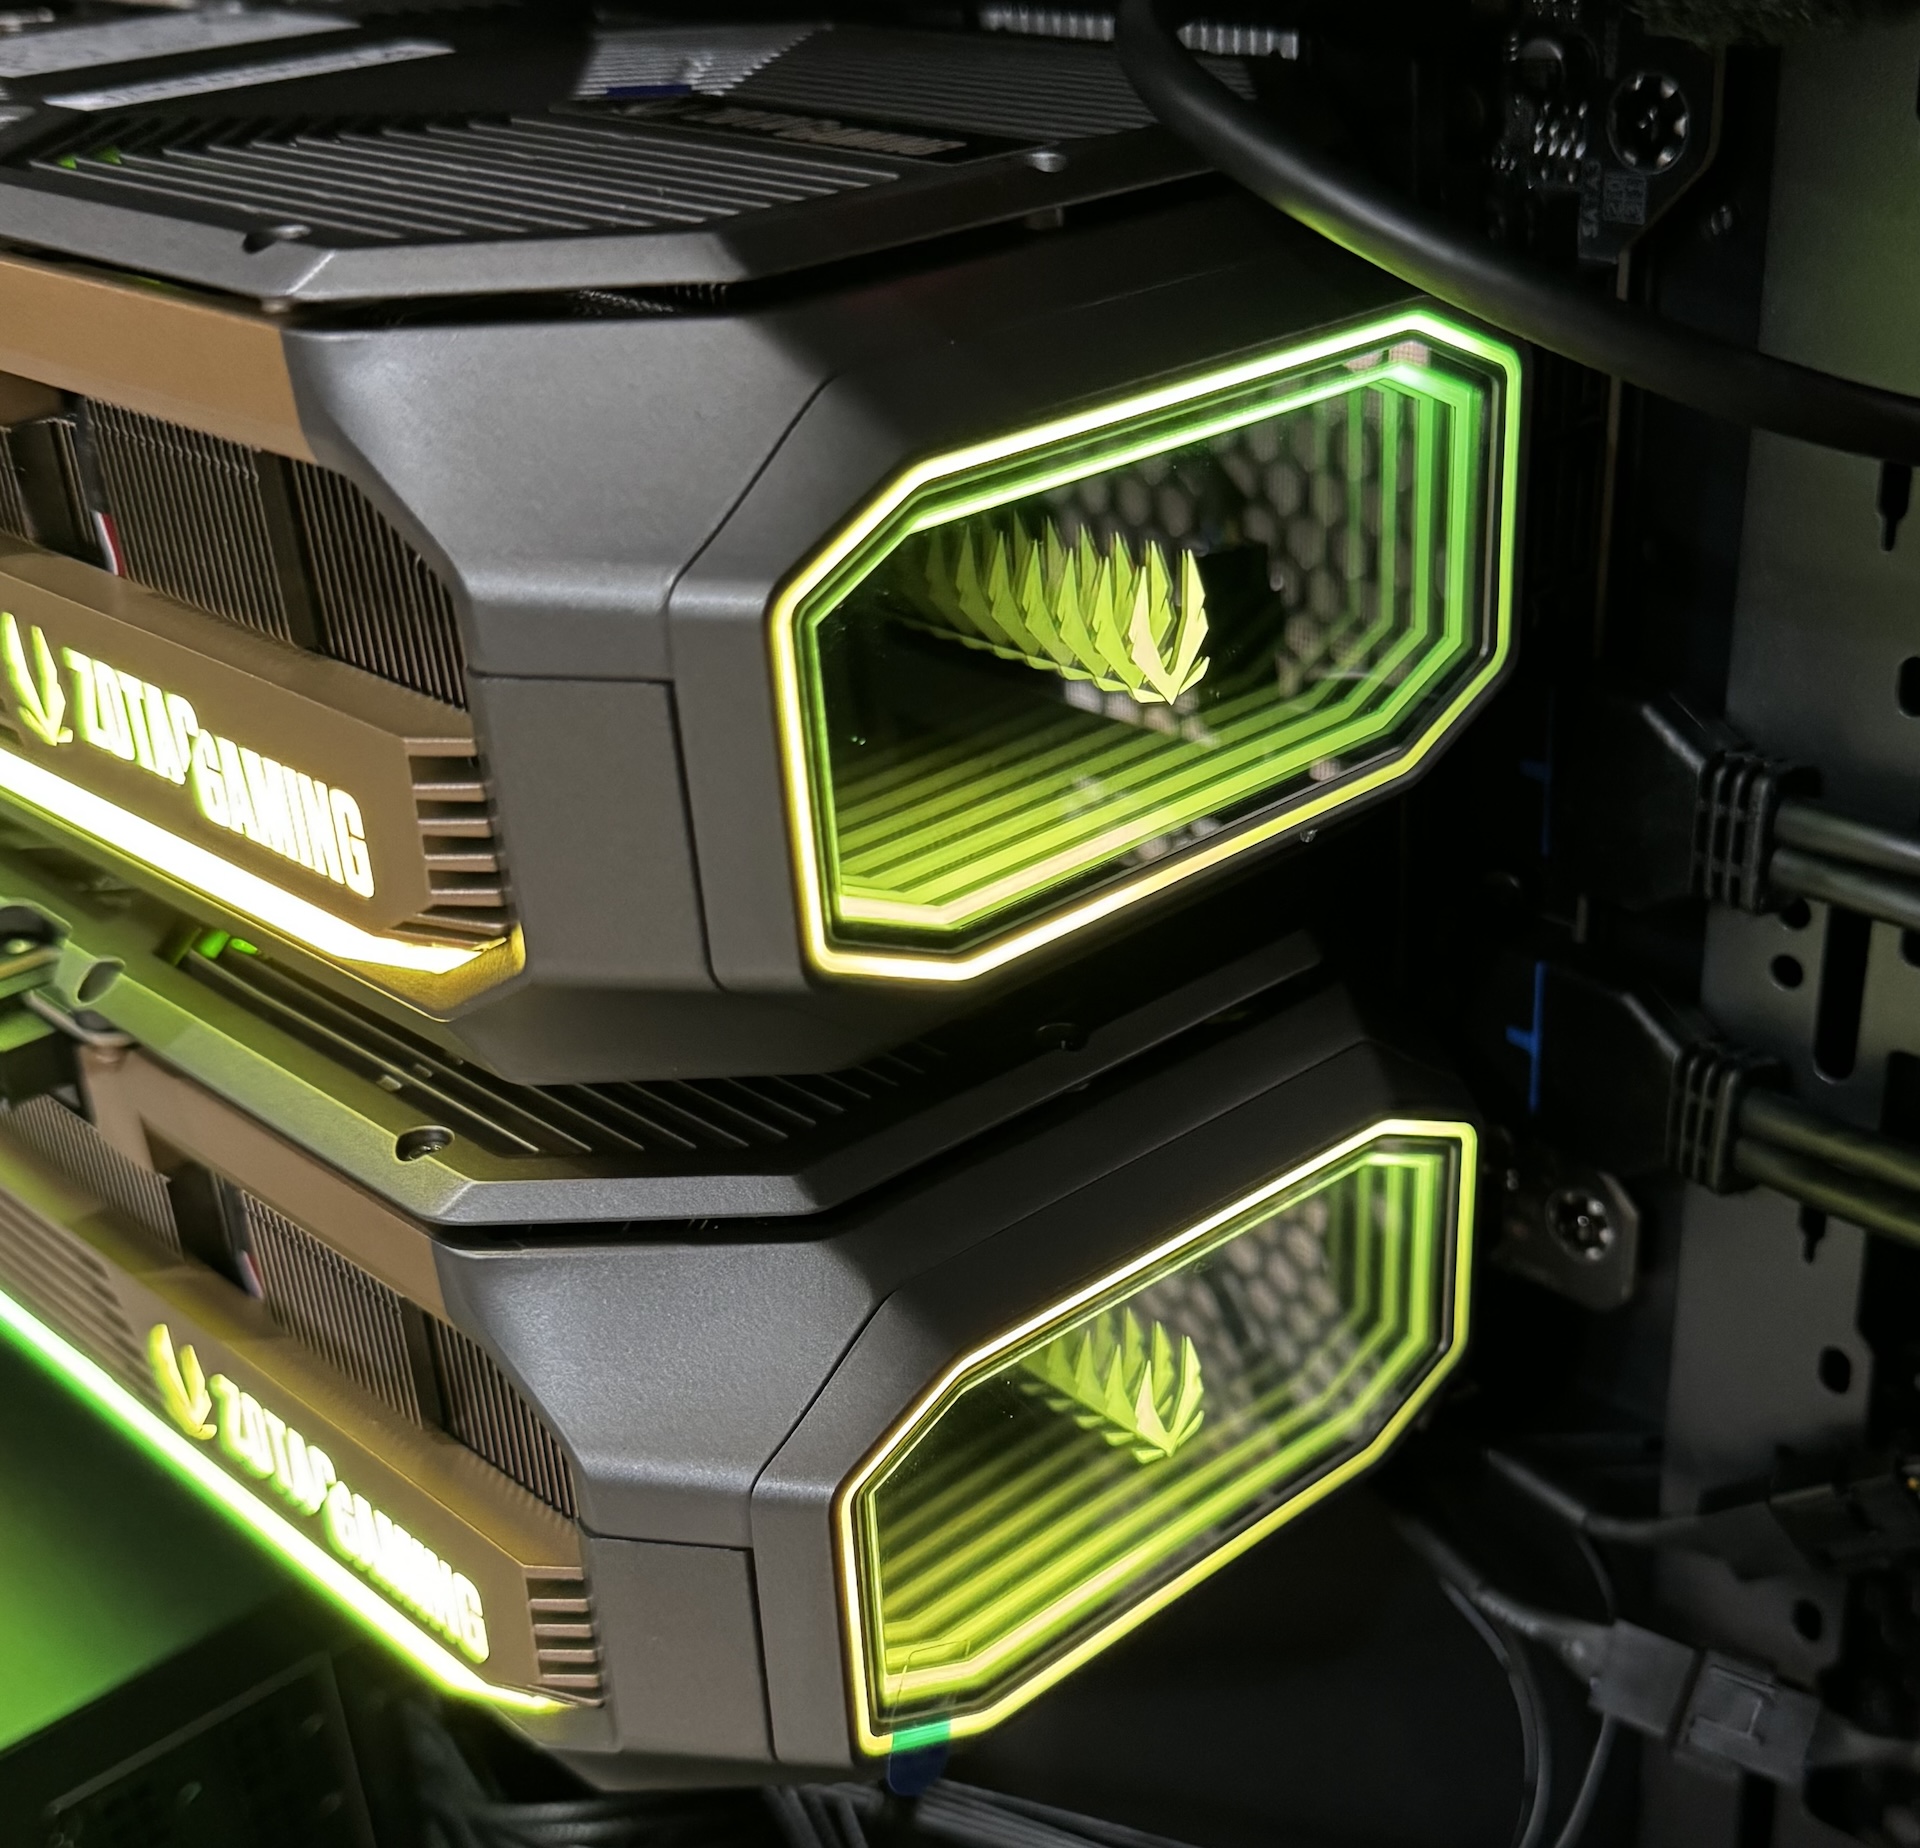
- RTX PRO 6000 96GB ×2または4 Blackwell GPU
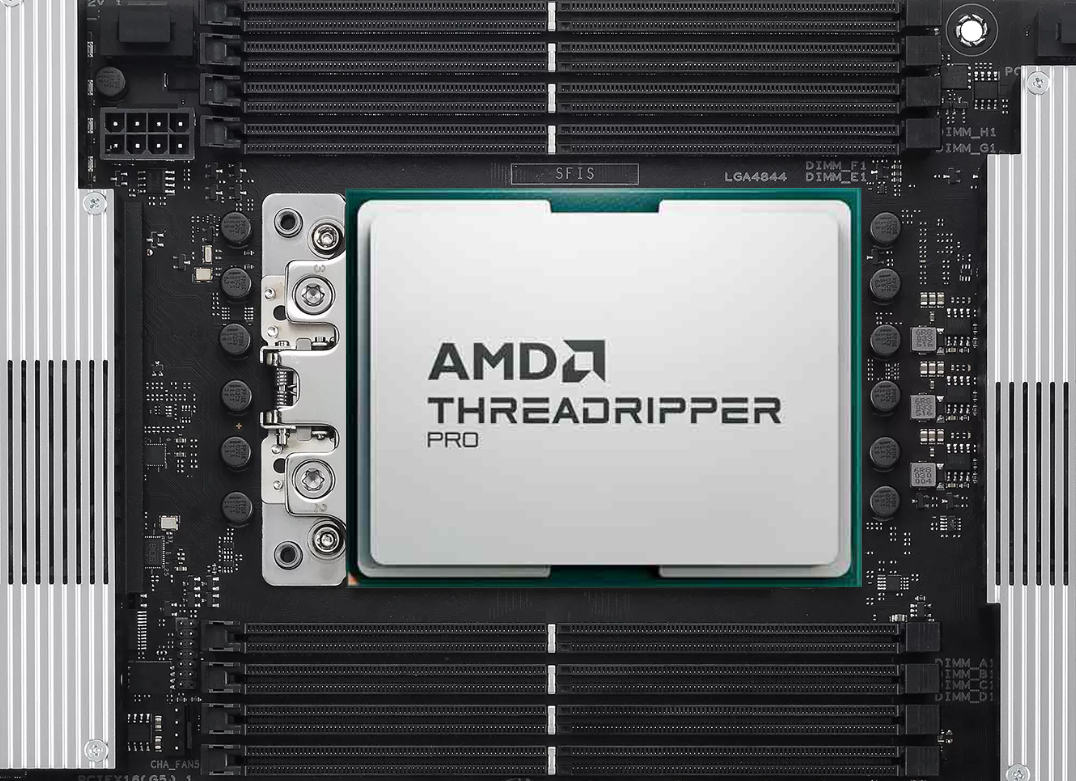
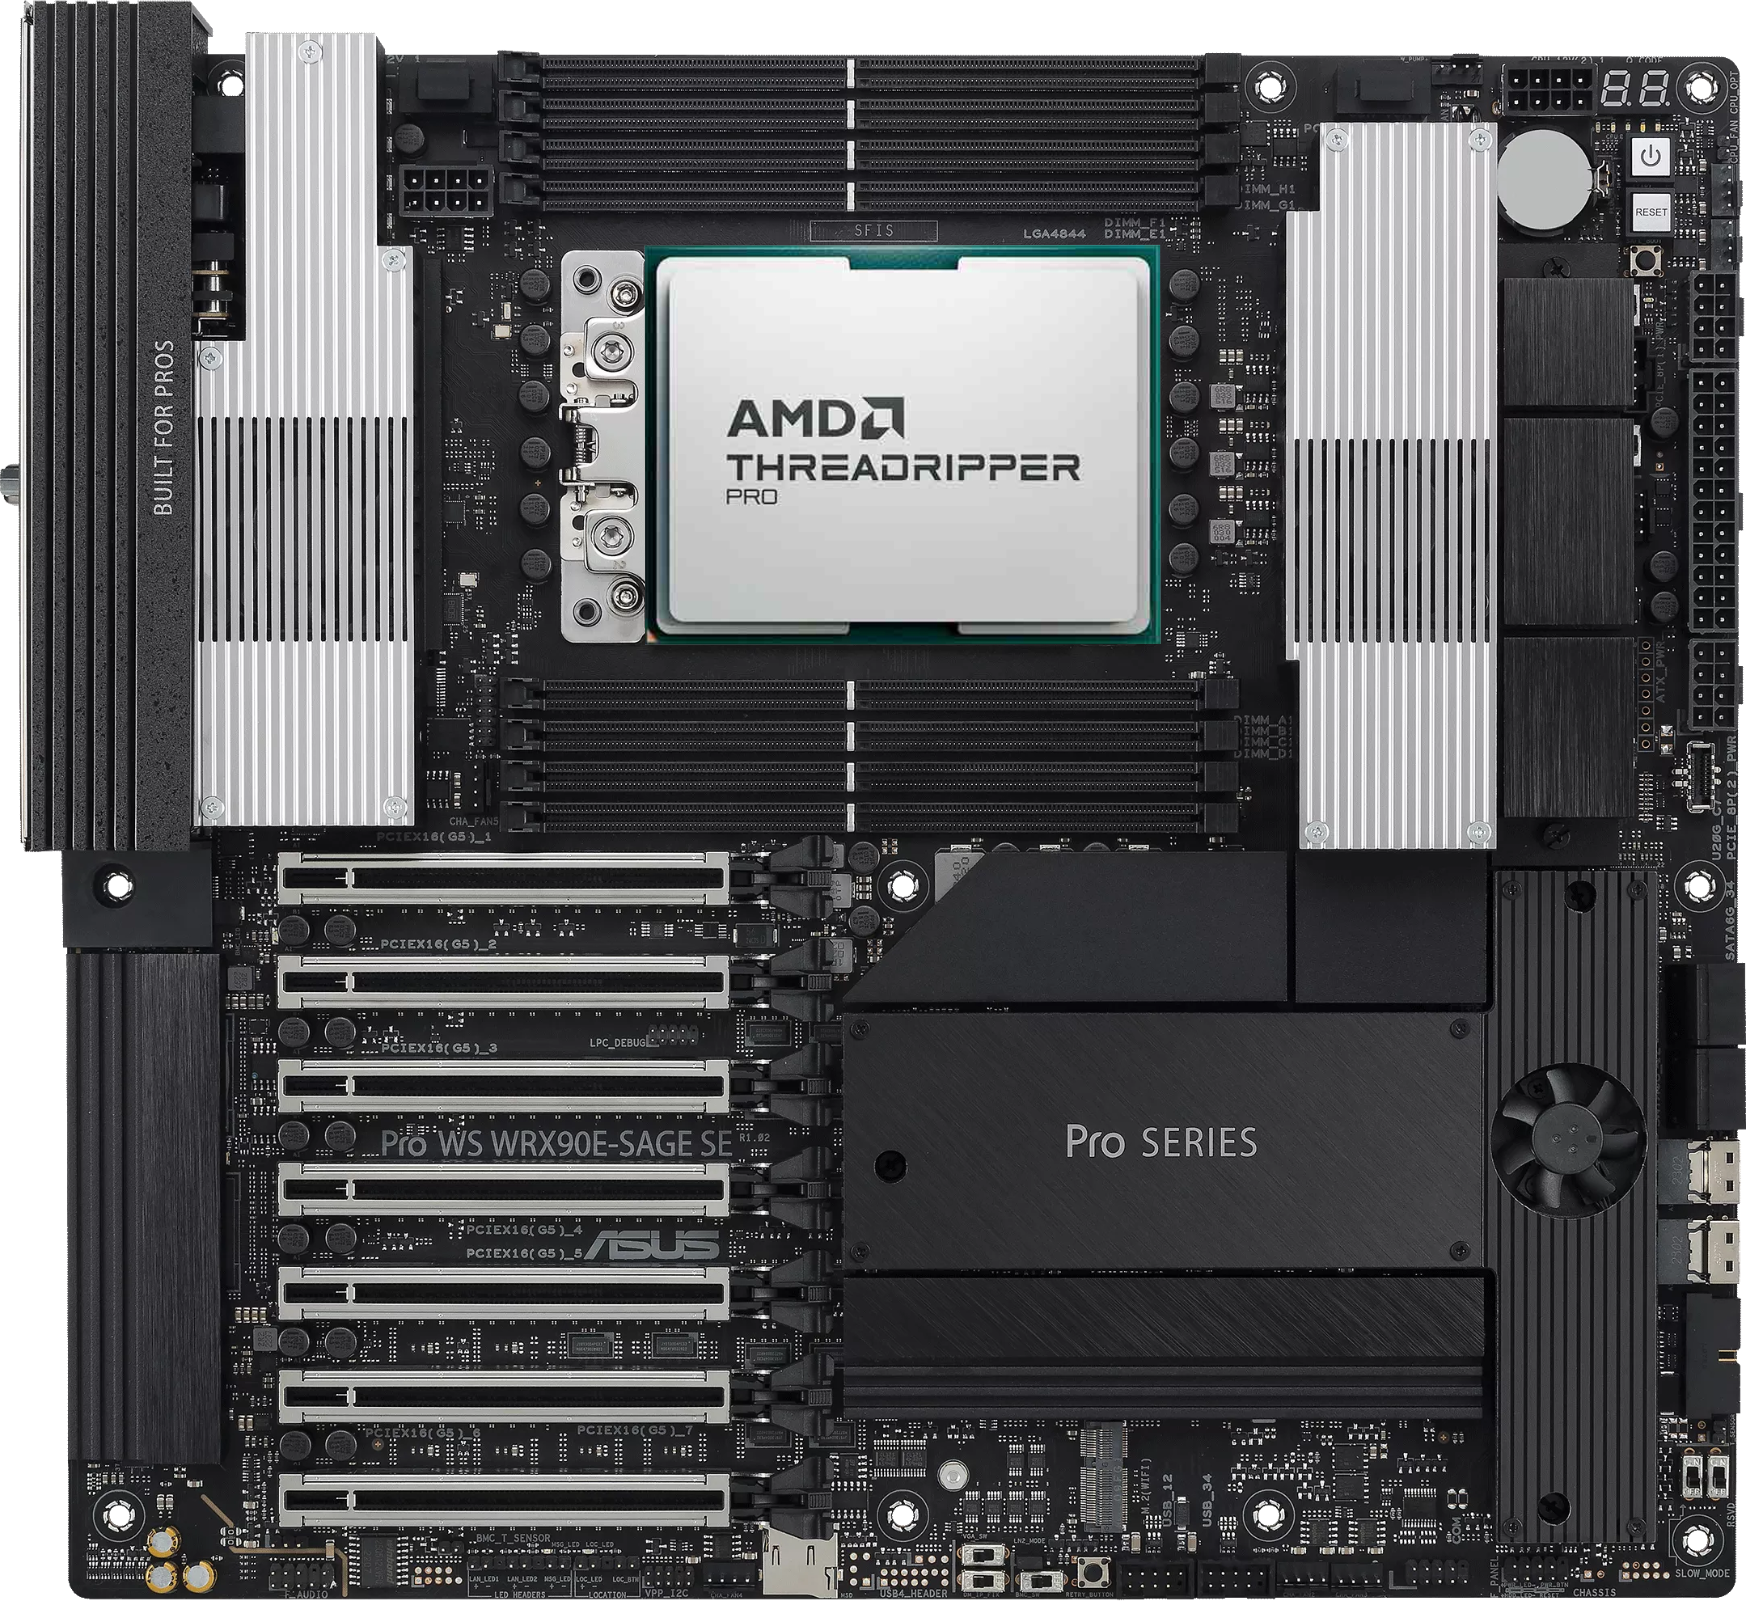
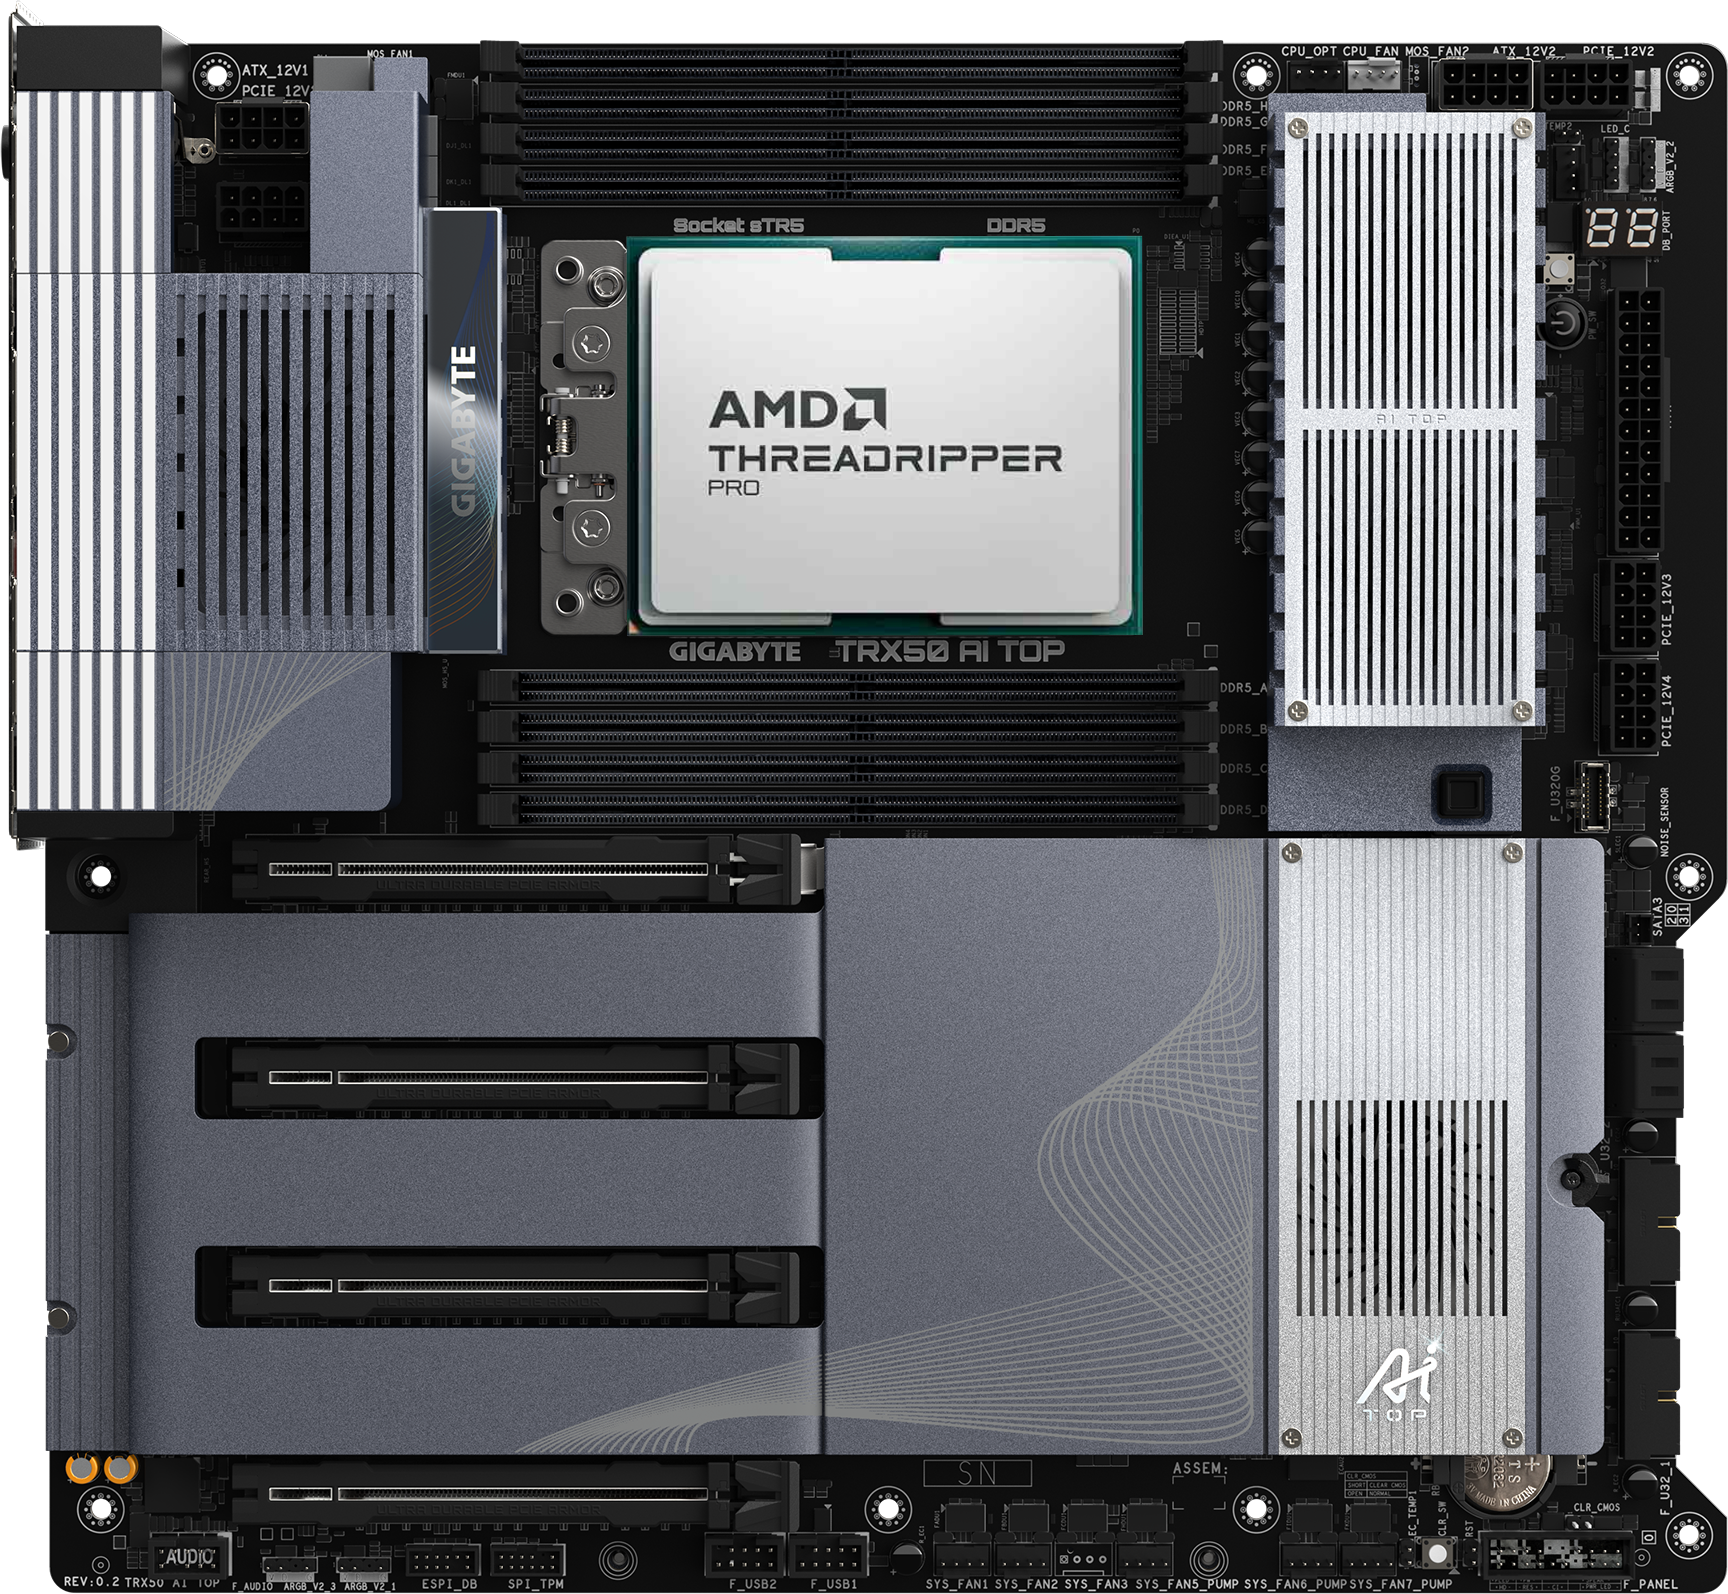
- 32コア AMD TR-PRO 9975WXプロセッサー
- 256GB DDR5 ECCメモリ
- 4TB NVMe SSDストレージ
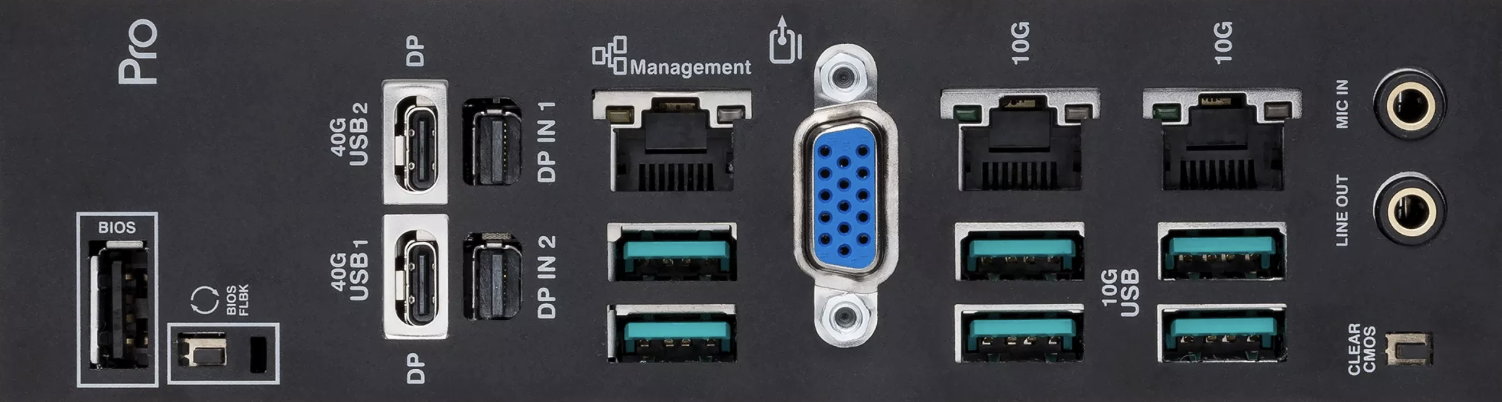
- 10Gbイーサネット、BMCリモート管理
- LLMモデルの学習・推論向け
- 在庫あり
gpt-oss-120bやgpt-oss-20b、Gemma、Llama 70Bなど業界トップクラスのオープンウェイト言語モデルを、低コストで高い実用性能とともに提供します。デバイス側アプリケーション、ローカル推論、あるいは高価なインフラを必要としない迅速なファインチューニングに適しています。大規模言語モデル(LLM)向けのAI Python開発環境をあらかじめインストール済みなので、届いたその日に電源を入れるだけですぐに制作や研究を始められます。
AI LLM大規模言語モデルワークステーションをカスタマイズ ワークステーションをカスタマイズ
専用のAIワークステーションを手軽に構築できます。MAQのウェブサイトでは、最高峰のPC仕様をご自身で構成でき、価格はすべて公開・透明です。プロセッサーやメモリから、最新のNVIDIA/AMD製AI GPUまで、すべてご要望に合わせてカスタマイズ可能です。さらに、ComfyUIやStable Diffusion、各種大規模言語モデル(LLM)などのAI Python開発環境をあらかじめインストール済みなので、届いたその日に電源を入れるだけですぐに制作や研究を始められます。
ワークステーションをカスタマイズ PCをカスタマイズ
アフターサービスも万全です。システムに何か問題が発生した場合も、専門チームがリモートでサポートし、迅速に解決します。修理やアップグレードが必要な場合は、代替機をご用意し、作業を中断することなくスムーズに対応します(本サービスは契約者様限定です)。購入前の構成アドバイスからご購入後のご利用・サポートまで、私たちが最初から最後まで伴走しますので、技術的な心配をせず、最も大切な業務に集中いただけます。
ワークステーションをカスタマイズ PCをカスタマイズ文書、SOP、データベースに散らばる企業の知識を、「対話で検索できる」プライベートAIアシスタントへと統合します。RAGナレッジベース × ナレッジグラフ × 権限監査のすべてを自社サーバー上で完結させ、機密データは外部に送信されず、トークン費用の心配もありません。NVIDIA RTX PRO 6000 96GB、単体GPUでgpt-oss-120Bを完全にロードできます。

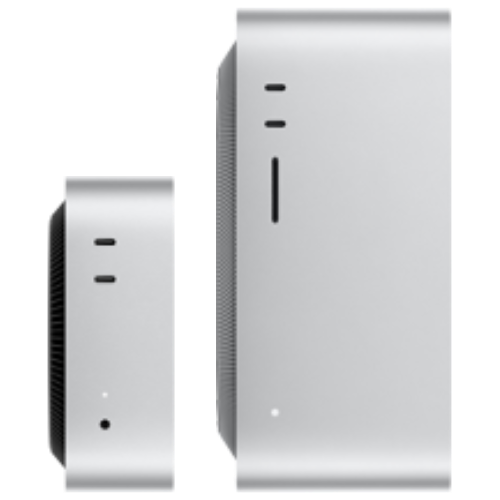
ディスクリートGPU路線は単体カードのビデオメモリが上限となりますが、Apple SiliconはCPUとGPUが同じ統合メモリプールを共有し、そのプール全体を推論に使えます。同じく単機で700億パラメータ級以上のモデルを載せる場合でも、Mac Studioは複数GPUの並列運用もテンソル並列も必要ありません。
代償となるのはエコシステムです。学習や大量の画像生成では、依然としてNVIDIA CUDAプラットフォームの方が成熟しています。作業の中心がローカル推論、プライベート検索、常駐エージェントであれば、Macラインの低騒音と省エネルギー性は実用上の明確な利点になります。
本ページのMac機種は出荷時にMLX、Ollama、llama.cppをプリロード済みです。全機種とメモリ容量別の対照表はMacワークステーションをご覧ください。
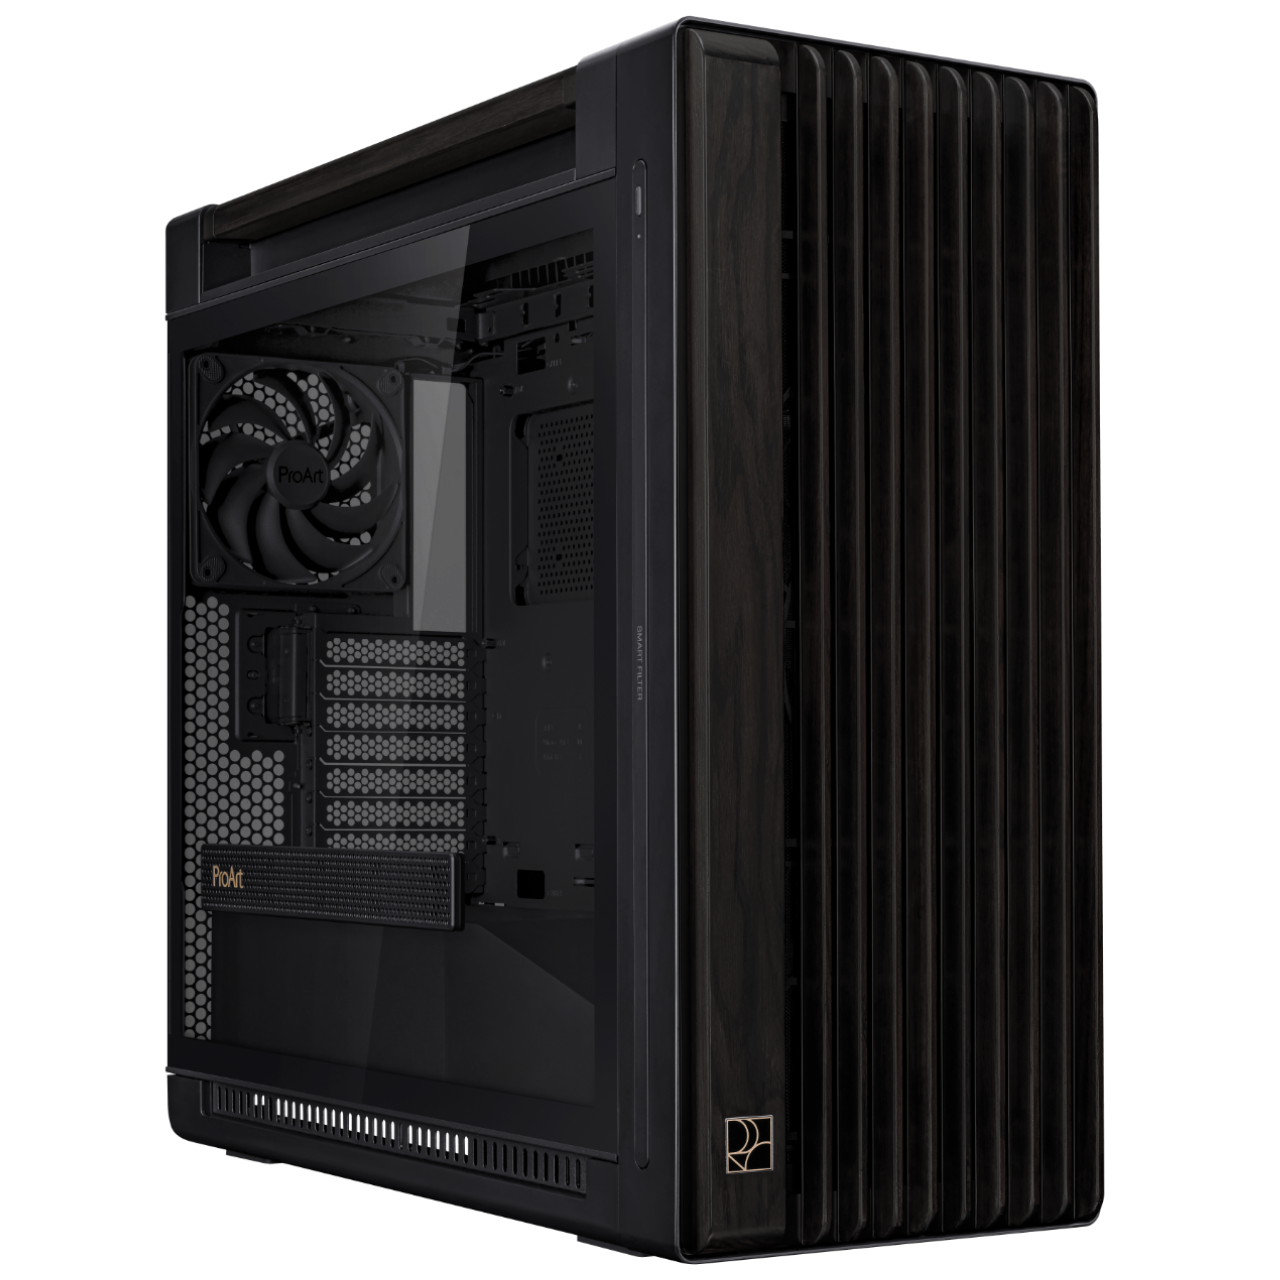
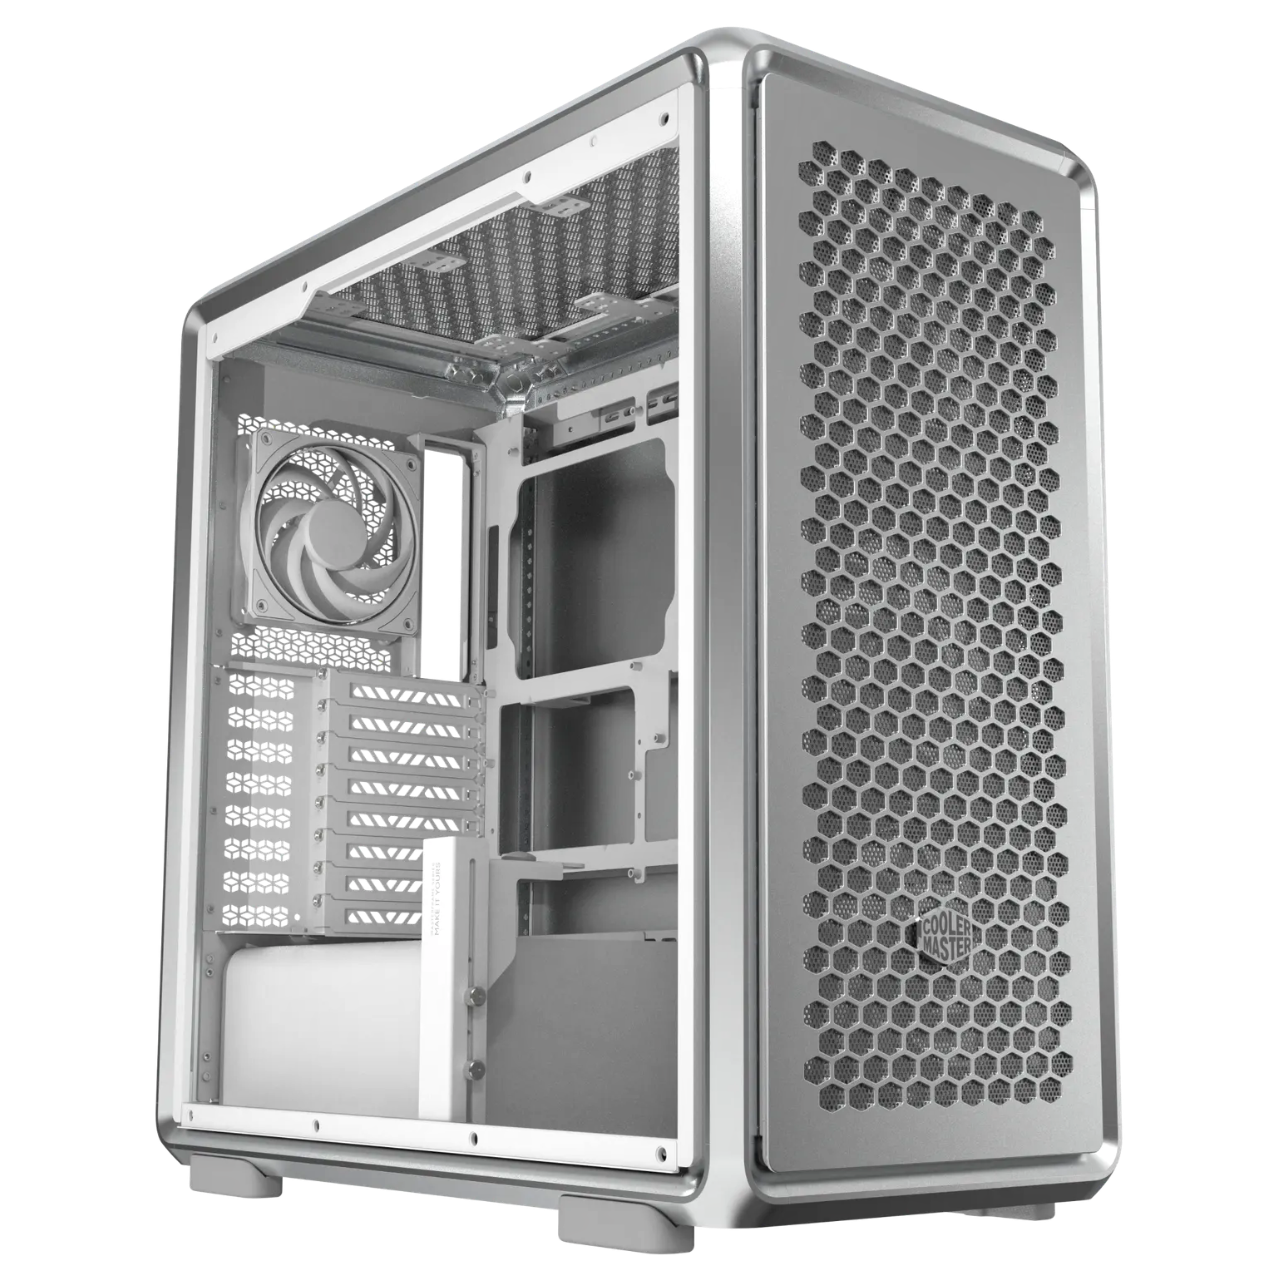
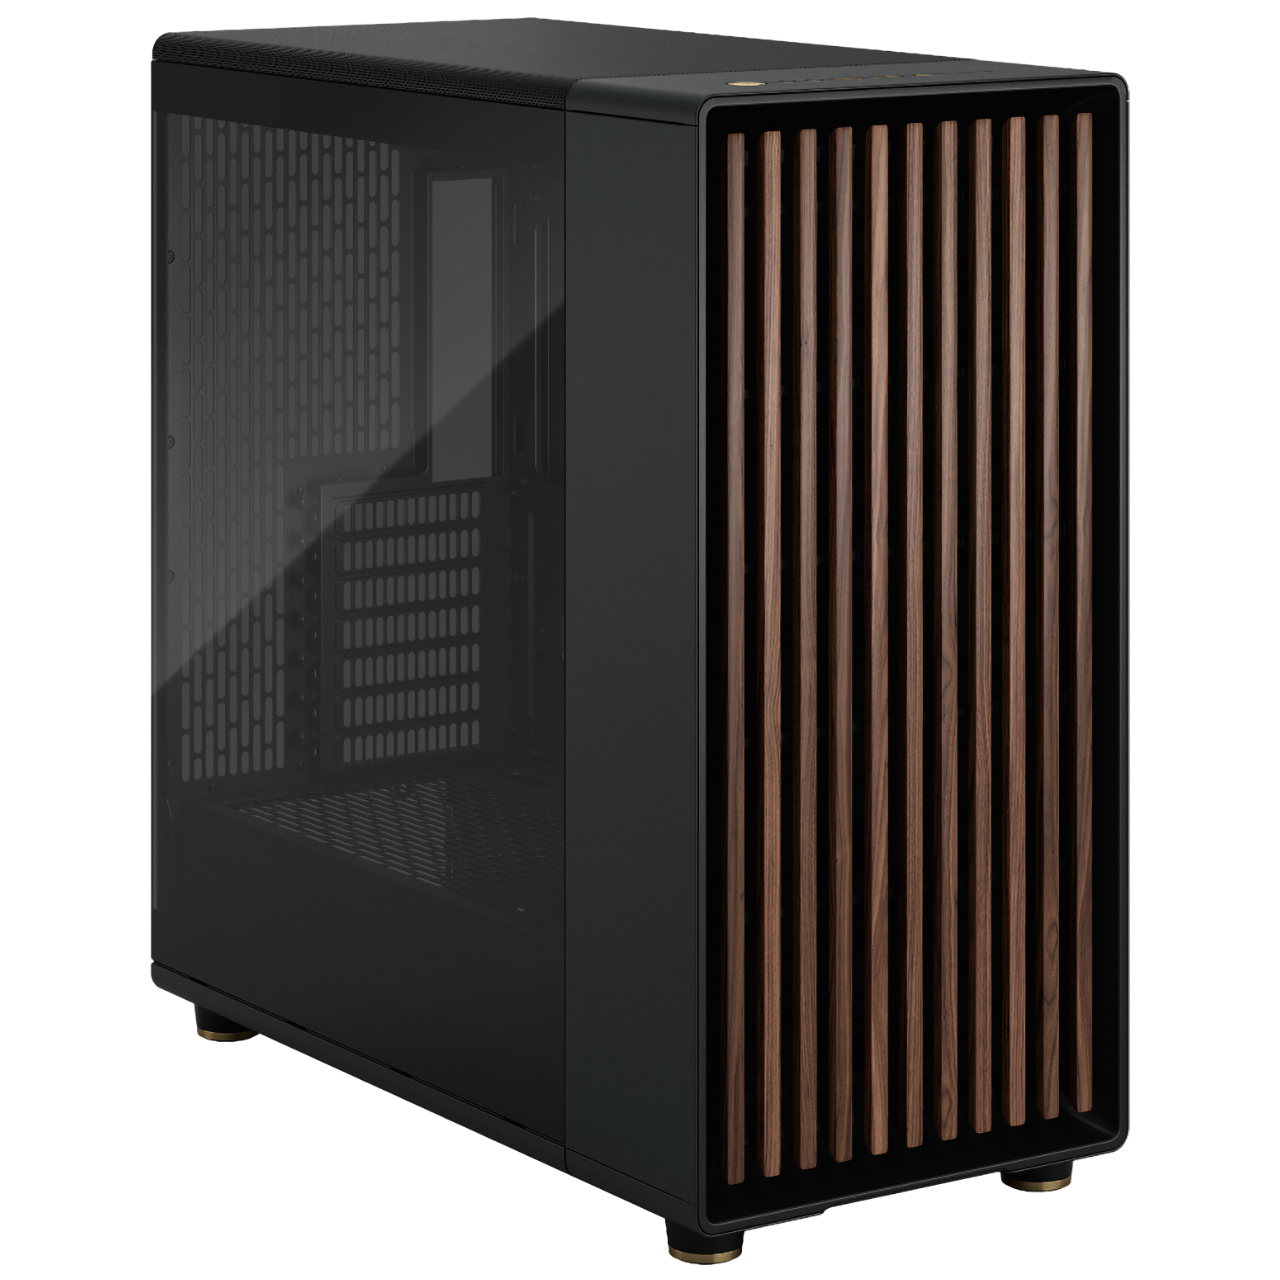
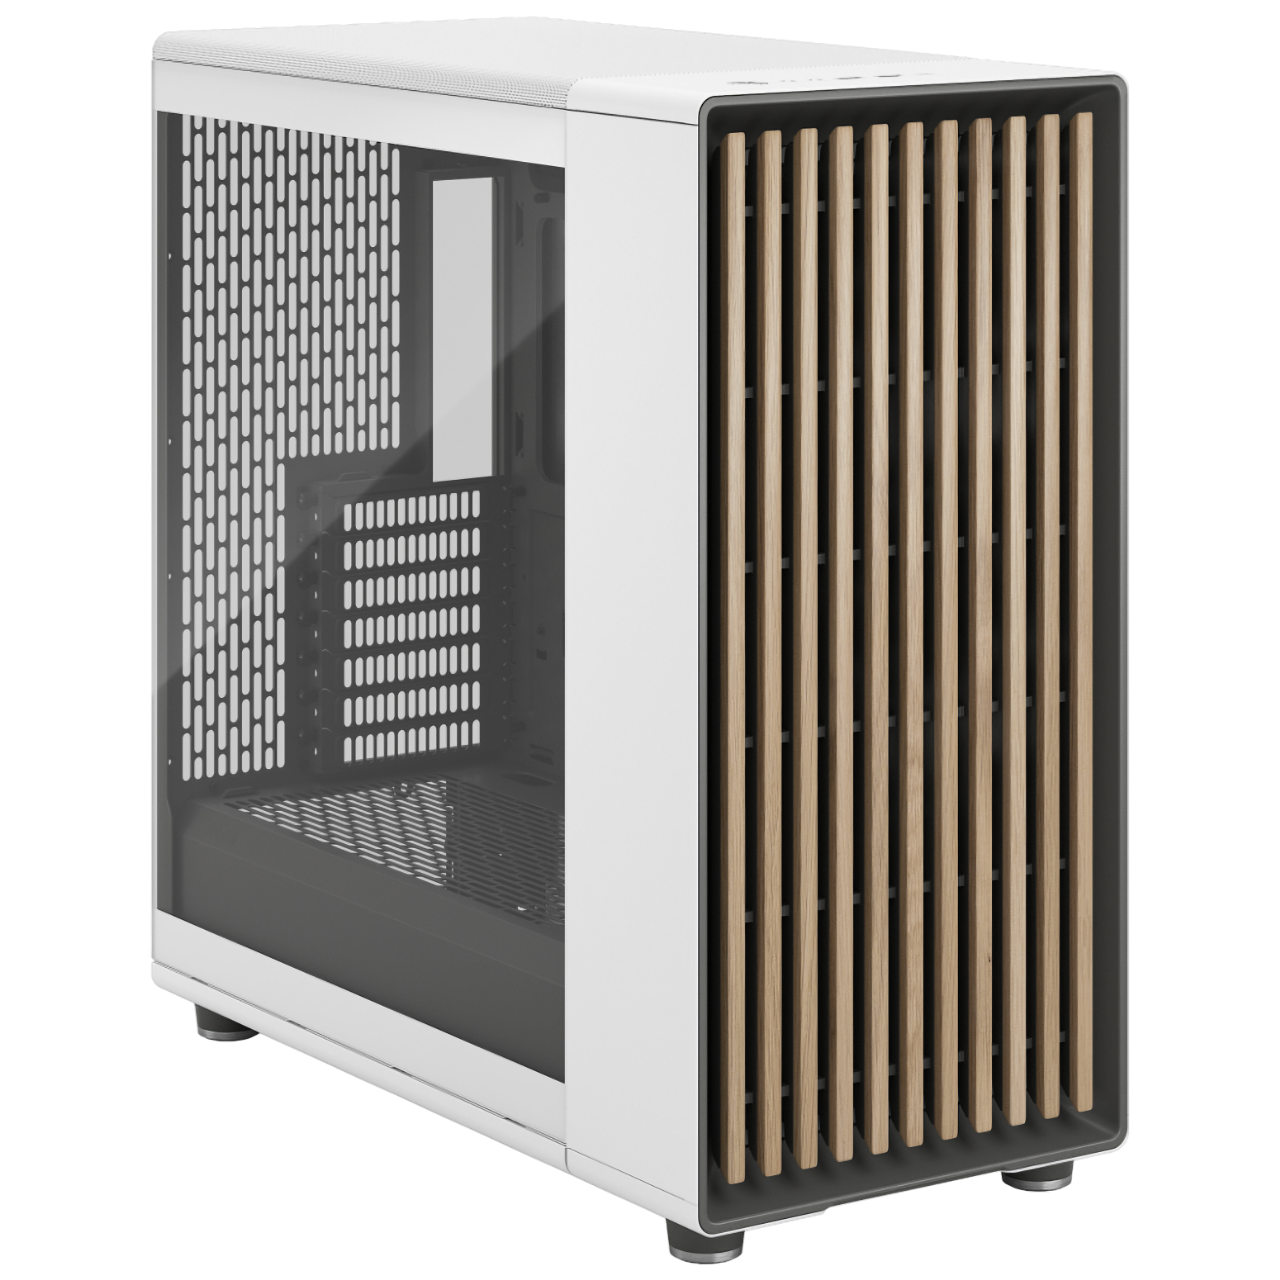
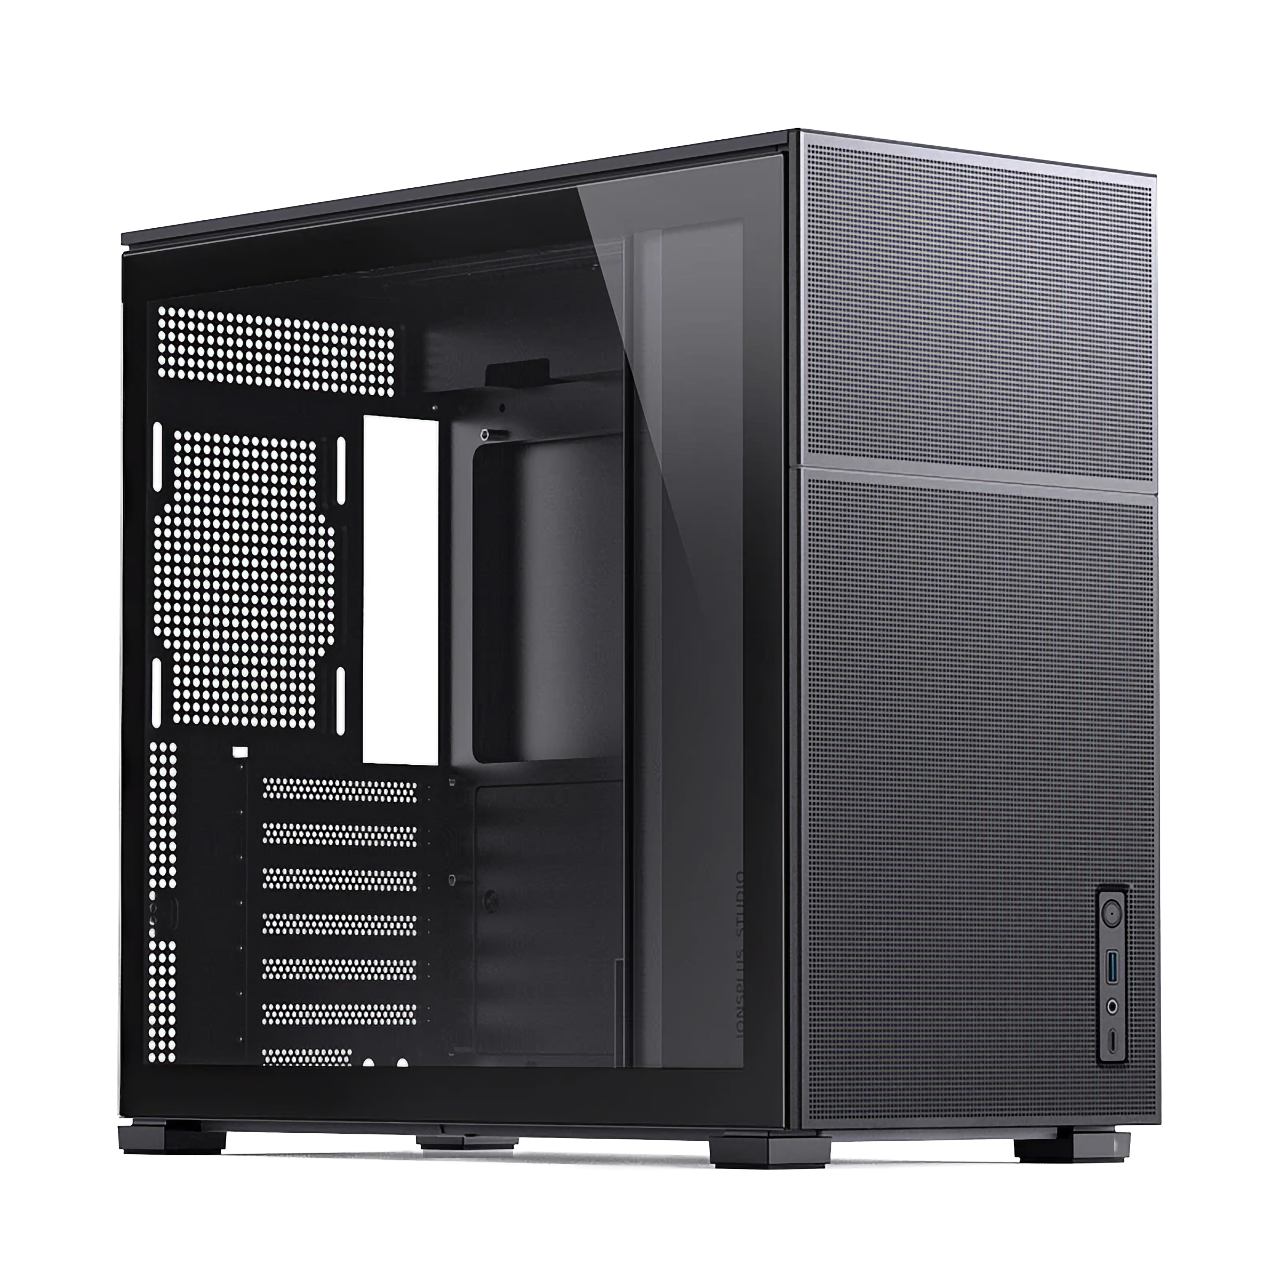
MAQでは、さまざまな価格帯とサイズを取り揃えた厳選のPCケースをご用意し、あらゆるニーズにお応えします。唯一違うのは、私たちが一台一台を、手作りの車のように隅々まで丁寧に仕上げていることです。
あなただけのワークステーションをカスタマイズ仕様に応じて gpt-oss-20b/120b、Llama 3.3 70B、Qwen3 32B(4-bit)、Gemma 4 などのローカル推論モデルを実行できます。RTX PRO 6000 96GB搭載モデルは量子化済み120Bモデルをロード可能、32GBクラスのモデル(AI-MediumのRadeon AI PRO R9700、AI-Medium-GemmaのRTX PRO 4500)は20Bクラスの量子化推論や13B全精度推論を快適に実行できます。
GPU VRAMは48GB以上(RTX PRO 5000クラス、または複数GPUの並列運用)、RAMは64GB以上、さらにNVMe SSDで重みの読み込みを高速化することを推奨します。MAQのAI-HighはRTX PRO 5000 48GB版を採用しており、ちょうどこの入門仕様に該当します。より余裕が欲しい場合は、RTX PRO 6000 96GB搭載のAI-Highendをご検討ください。
出荷時にOllama、PyTorch、CUDA、vLLM、ComfyUIなどの推論・学習フレームワークに加え、Claude Code、Cursor、Codex CLI、LangGraph、CrewAIといったエージェント型AI開発ツールをプリインストールしています。機種に応じて対応するLLMの重みファイル(gpt-oss、Llama、Gemmaなど)もプリロード済みで、購入後すぐにご利用いただけます。
MAQはリモート技術サポート、ソフトウェア環境の設定支援、契約者向け代替機サービス(修理期間中は近い仕様の代替機を貸出)を提供し、システムの問題解決をサポートすることで作業の中断を防ぎます。契約者は台湾全域で翌営業日訪問のサービスをご利用いただけます。
主にmacOS環境でMLXフレームワークを使用する、または4K/8K動画を編集する場合は、統合メモリが大容量(最大512GB)で省電力なMac Studioが適しています。CUDAエコシステム(PyTorchでの学習、ComfyUI、vLLM)が必要な場合は、RTXワークステーションがより適しています。
可能です。MAQは標準ATXケースと産業グレードの電源を採用しているため、GPU、メモリ、SSDは後からご自身で、または弊社を通じてアップグレードでき、一体型マシンのような制約がありません。